Europaius for jurister: sådan fungerer grænsefladen, og hvorfor du kan stole på den
Ret i 26 stater i én grænseflade. Du uploader dit dokument, grænsefladen konverterer det til tekst på serveren, anonymiserer det og finder frem til love og afgørelser fra et verificeret korpus baseret på den anonymiserede tekst. Du får et udkast med citater, der rent faktisk findes. Dokumentet forsvinder efter serverens svar.
60 495 Love17 114 Retspraksis3 741 Love med AI-forklaring
Hvad grænsefladen kan
Hver paragraf og afgørelse i udkastet er en henvisning til korpusset. Det, der ikke findes i korpusset, citerer grænsefladen ikke; ved udkastet ser du graden af opbakning i kilderne.
Tjekkiet og 25 EU-lande med ECLI, fulde tekster og nationale kilder. Én forespørgsel, ét svar, grænseoverskridende research uden at skifte mellem databaser.
Navne, numre og adresser erstattes med stedfortrædere, før teksten ses af sprogmodellen. Kortet over stedfortrædere forbliver i browseren, dokumentet gemmes ikke.
Søgning i love og retspraksis på tværs af grænser: én forespørgsel gennemsøger både lovgivning og domstolsafgørelser i det pågældende land, eventuelt i flere lande samtidig, med ECLI-identifikator og link til den fulde tekst. Søgning er gratis og kræver ingen registrering.
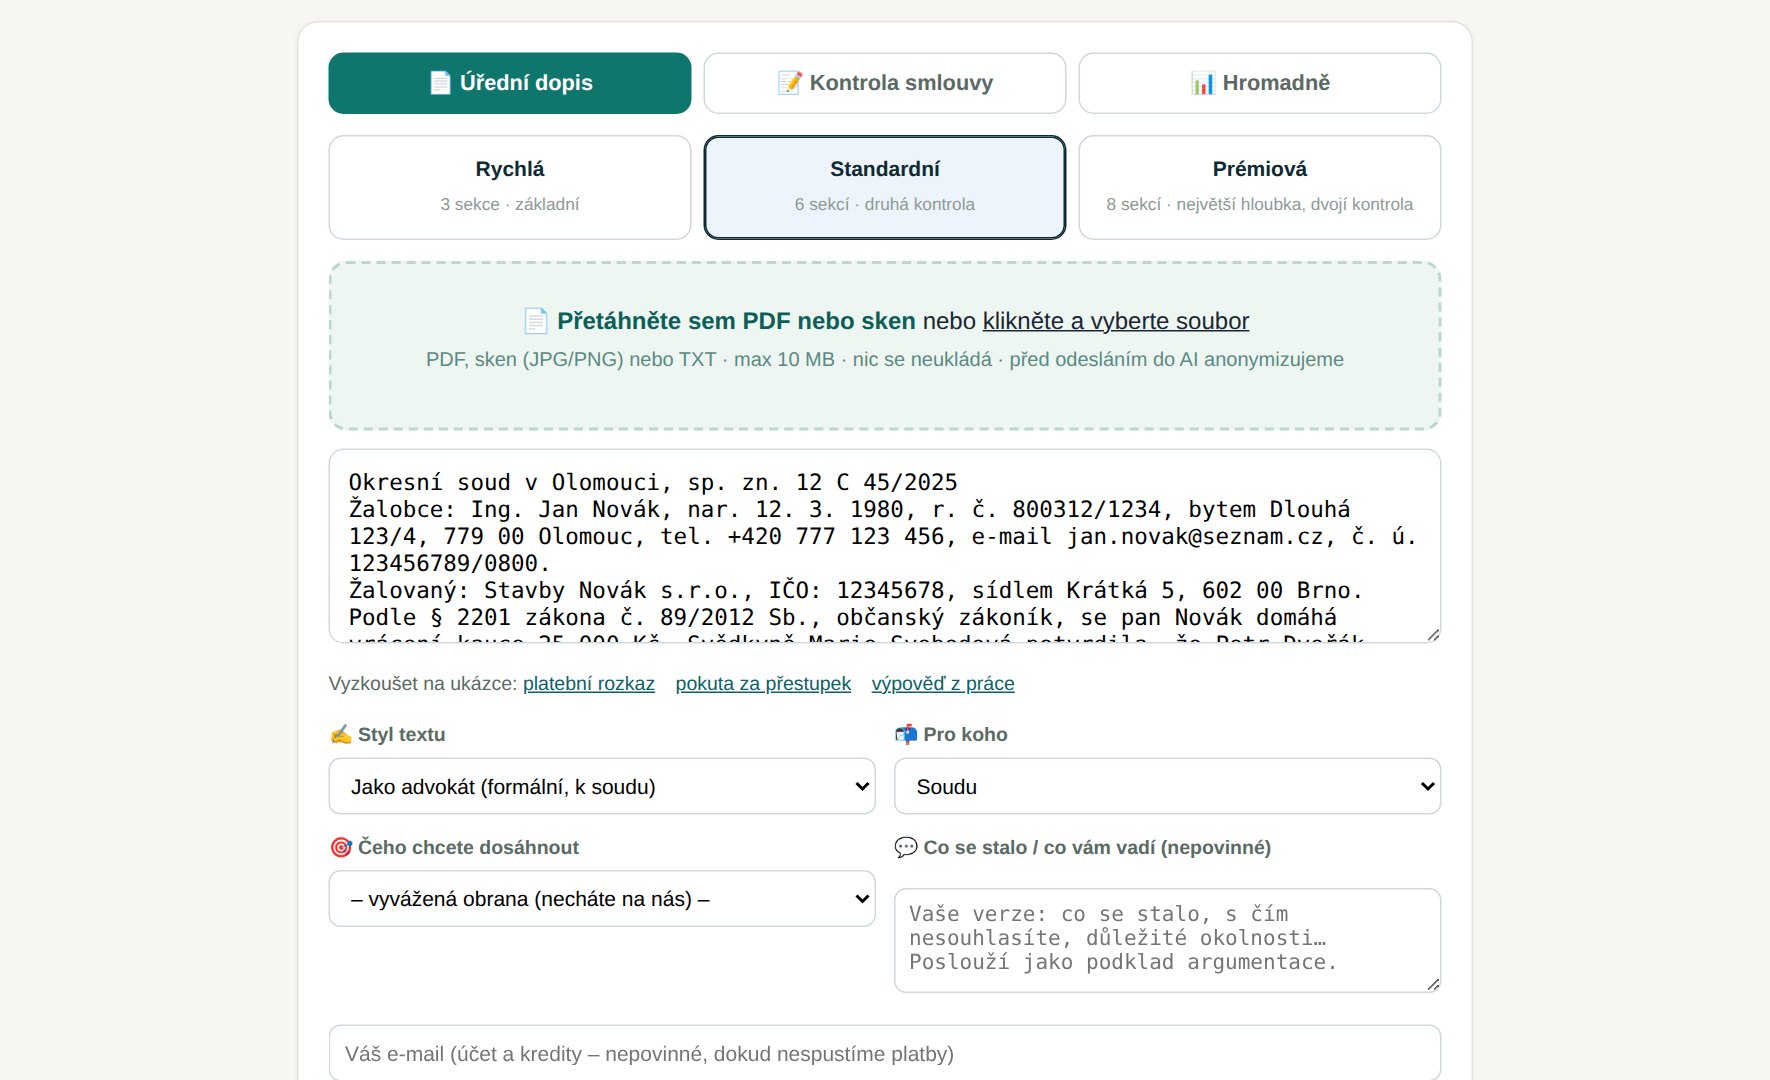
Analyse af officielle skrivelser og udkast til indlæg: du uploader et betalingspåkrav, en henvendelse fra en myndighed, en opsigelse eller en stævning, og grænsefladen udtrækker frister, trin og relevante bestemmelser fra det verificerede korpus, hvorefter den udarbejder et forsvarsudkast inddelt i sektioner, hver med citater, der er verificeret mod korpuset. Dokumentanalyse.
Kontraktgennemgang: grænsefladen finder risikable klausuler, knytter dem til lovbestemmelser og foreslår ændringer. Masseanalyse behandler snesevis af dokumenter på én gang.
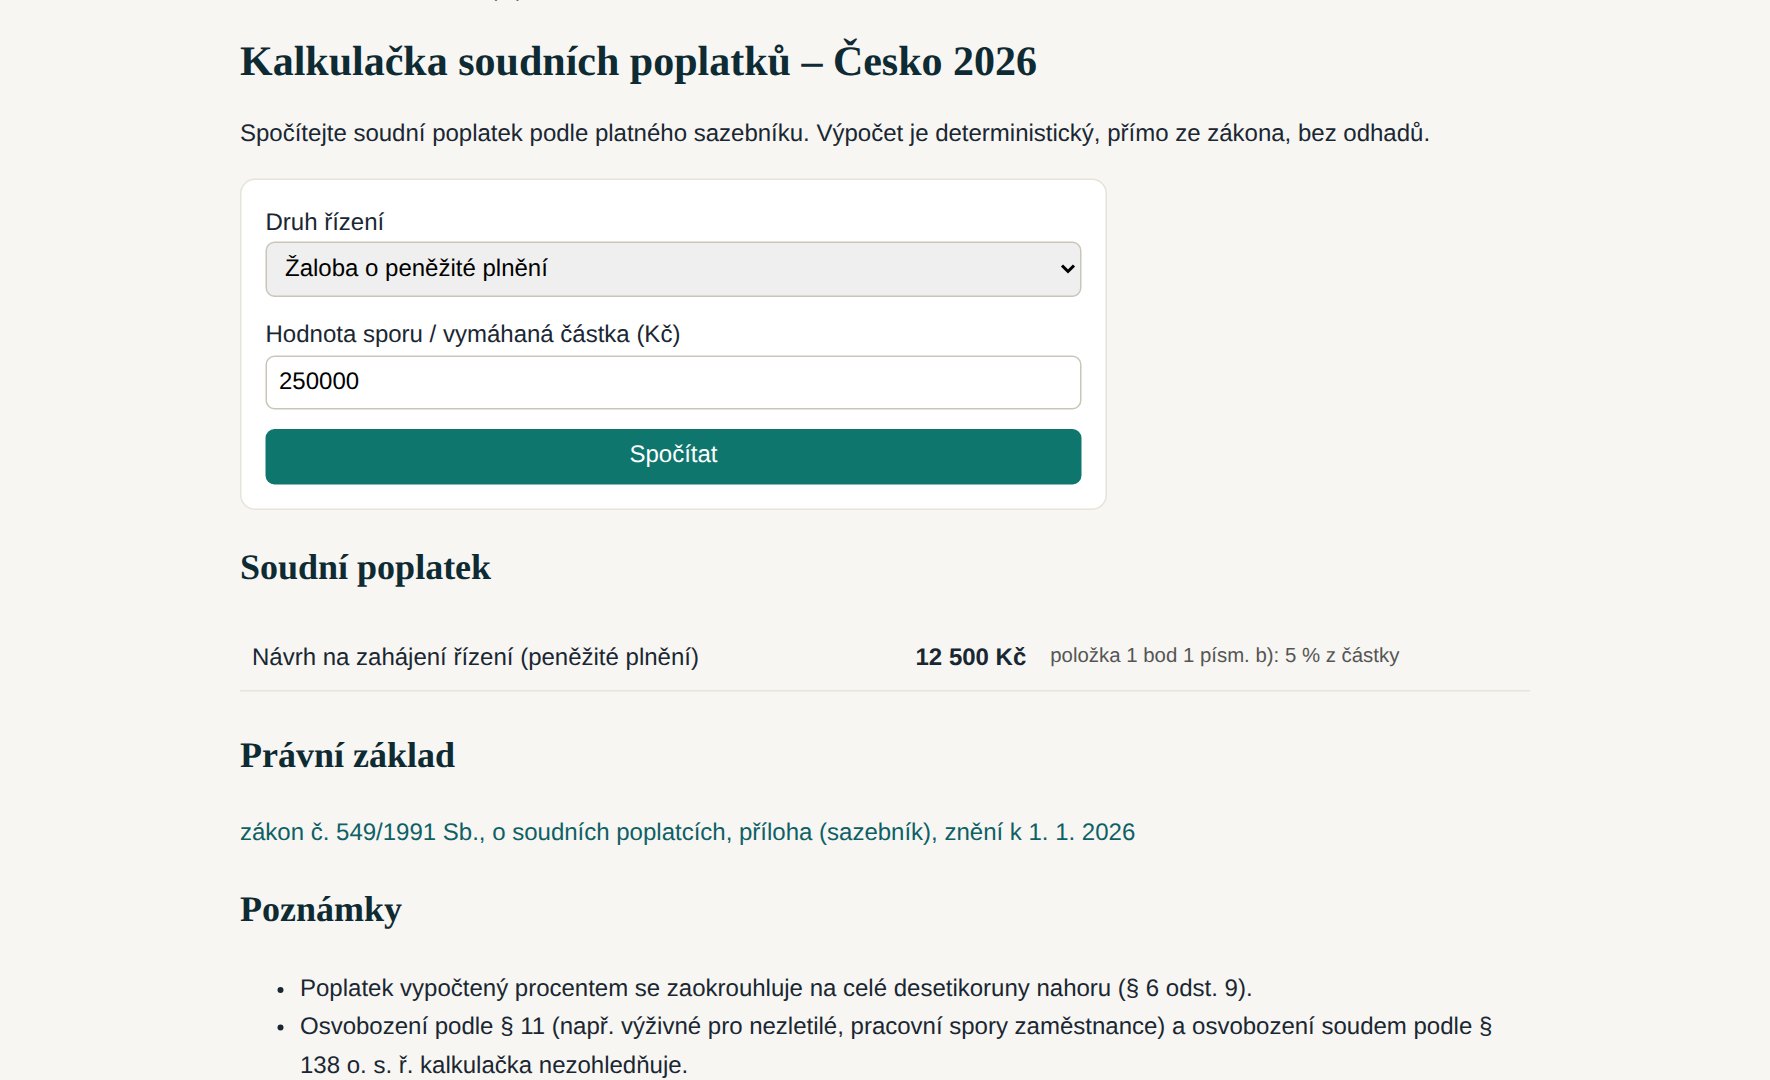
Retsgebyrberegner baseret på den lovbestemte takstliste for tolv lande, dokumentanonymisering som selvstændigt værktøj og MCP-forbindelse, hvormed du kobler hele korpuset til Claude, ChatGPT, Copilot eller din egen agent.
- Hver paragraf og hver afgørelse, som grænsefladen citerer, findes i korpuset; resultatet viser, hvor stor en procentdel af teksten der understøttes af verificerede kilder (grounding).
- Resultaterne er mærket som skabt af kunstig intelligens og udgør ikke juridisk rådgivning; de er et grundlag for dit arbejde, ikke en erstatning for det.
Hvilke kilder vi søger i for dit land
Vi opbygger korpuset ud fra officielle portaler for lovgivning og retspraksis i hvert land. Nedenfor ses en oversigt over de kilder, vi trækker på for dette land; antallet af dokumenter i korpuset ses i boksen ovenfor dette afsnit.
Officielle portaler for lovgivning og retspraksis, som korpuset er opbygget ud fra, og som resultaterne linker til.
- Retsinformation – love og bekendtgørelser lovgivning
- Domsdatabasen – domme retspraksis
Desuden for alle lande: EUR-Lex (EU-ret) og HUDOC (Den Europæiske Menneskerettighedsdomstol).
Hvad der sker med et uploadet dokument
Forløbet er designet, så sprogmodellen aldrig ser personoplysninger fra dit dokument, og så dokumentet ikke forbliver gemt nogen steder efter behandling.
1. Upload. Vi modtager PDF med tekstlag, scanninger og fotos (JPG, PNG) samt almindelig tekst. Overførslen er krypteret.
2. Konvertering til tekst på vores server. PDF-filer læses med værktøjet pdftotext, scanninger genkendes med OCR direkte på serveren (Tesseract, sprog inklusive tjekkisk, slovakisk, tysk, engelsk, fransk, polsk, spansk, italiensk og hollandsk). Cloud-baseret genkendelse anvendes kun, hvis den lokale OCR fejler, og altid først efter din bekræftelse.
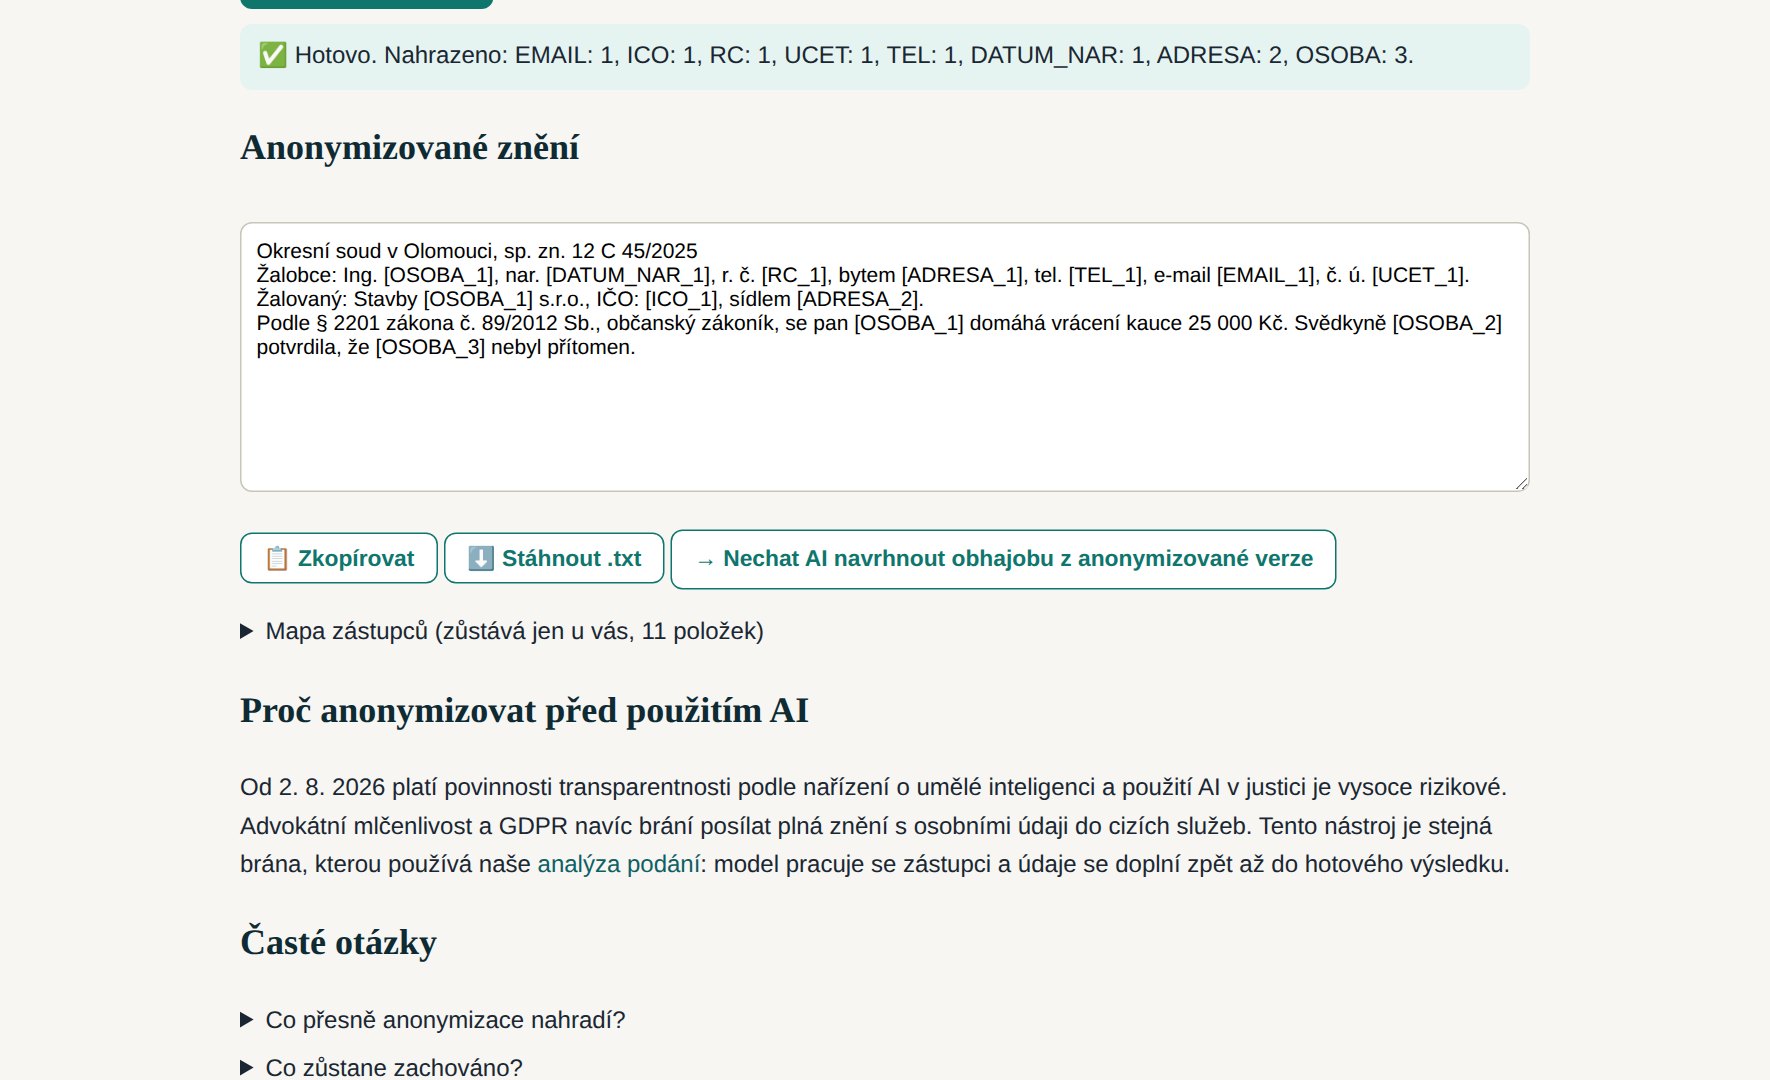
3. Anonymisering. For- og efternavne, inklusive bøjede former, personnumre, CVR-/momsnumre, kontonumre og IBAN, telefonnumre, e-mailadresser, fødselsdatoer og adresser erstattes med pladsholdere som [PERSON_1] eller [ADRESSE_2]. Sagsnumre, henvisninger til love og paragraffer samt navne på domstole, myndigheder og virksomheder bevares, så teksten fortsat er juridisk læsbar. Du kan se og redigere den anonymiserede version.
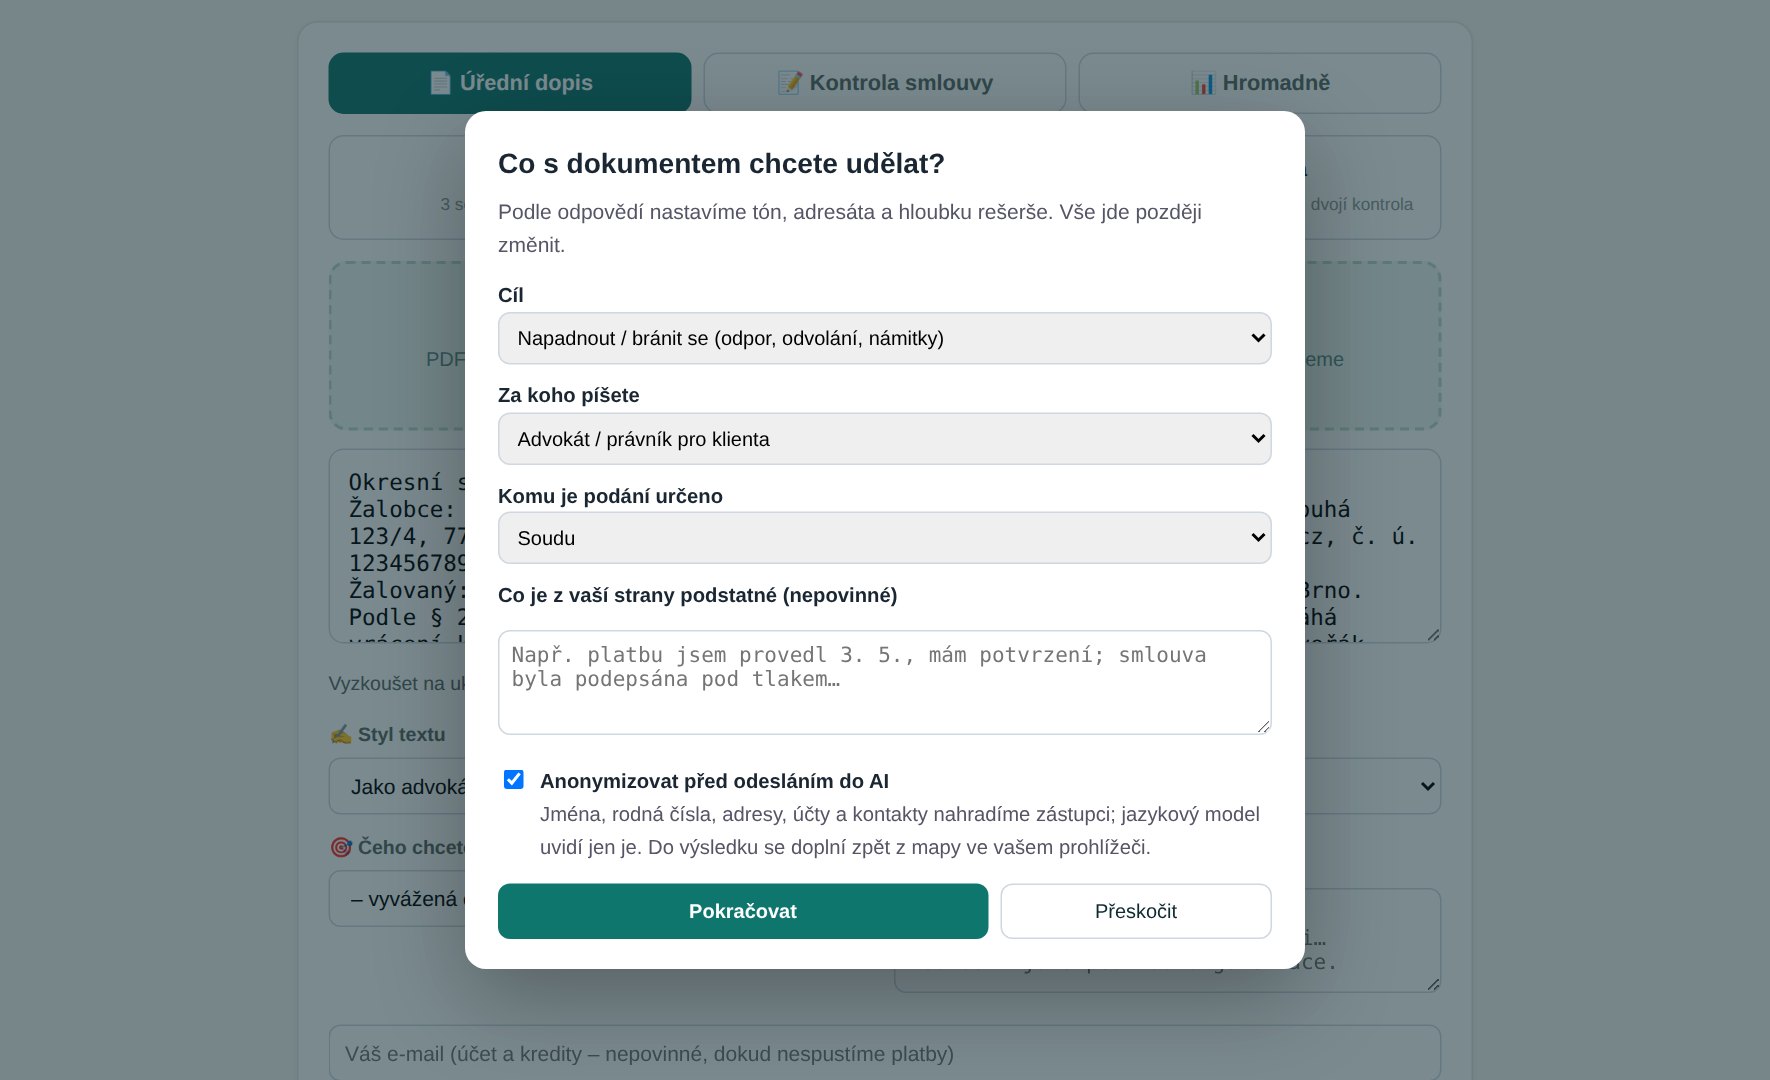
4. Vinduet „Hvad vil du gøre med dokumentet“. Efter upload spørger vi, hvad du ønsker at opnå (anfægte, forklare, annullere, indgå forlig, nedsætte en sanktion, vinde tid), på hvis vegne indlægget skrives (advokat for en klient, på egne vegne, virksomhed), og hvad der er væsentligt fra din side. Ud fra dette fastlægges tone, modtager og dybden af research.
5. Research og udkast. Modellen modtager kun den anonymiserede tekst samt uddrag af love og afgørelser, som grænsefladen har fundet i korpuset. For hver sektion i udkastet verificeres citaterne: paragraffen skal findes i den officielle lovsamling eller national lovgivning, afgørelsen i domstolsdatabasen.
6. Tilbageførsel og sletning. Kortet over pladsholdere forbliver kun i din browser; det færdige udkast suppleres med de oprindelige navne og oplysninger først hos dig. Dokumentet og mellemresultaterne findes kun i serverens arbejdshukommelse under behandlingen og kasseres, når svaret er sendt.
Hvorfor og hvordan der anonymiseres
Advokaters tavshedspligt, GDPR og fra 2. august 2026 også forpligtelserne efter AI-forordningen forhindrer, at fuld tekst med personoplysninger sendes til udenlandske tjenester. Anonymisering er derfor en indgangsport i grænsefladen, ikke et tilvalg: den kører før hvert kald til modellen og kan også startes separat med knappen Anonymisér dokument.
Reglerne bygger på det, som det tjekkiske justitsministeriums anonymiseringsværktøj har fastlagt for domstolene: navne, adresser, fødselsdatoer, identifikationsnumre, kontonumre og titler erstattes. Samme person får altid samme pladsholder, så argumentationen forbliver sammenhængende. Det regelbaserede værktøj kan overse usædvanlige navneformer eller adresser uden postnummer; kontrollér derfor resultatet, inden det anvendes – ved domstolsafgørelser er menneskelig kontrol obligatorisk.
Det selvstændige værktøj Dokumentanonymisering returnerer den anonymiserede tekst til download samt et kort over pladsholdere, som kun du modtager. Det er velegnet til overdragelse af sagsakter til en ekstern rådgiver, til undervisning eller til eget arbejde med en anden AI.
Sikkerhed og privatliv
- Serverne står i EU (Tyskland), overførslen er TLS-krypteret, og ingen leverandør uden for EU har adgang til systemet, bortset fra selve sprogmodellen, som kun ser den anonymiserede tekst.
- Dokumentet gemmes ikke på disk, forbliver ikke i logfiler og bruges ikke til træning af modeller; det forsvinder fra serverens hukommelse, når svaret er sendt. Vi opbevarer kun antallet af erstattede oplysninger fordelt på type (f.eks. „person 3, adresse 1“), uden indhold.
- Kortet over pladsholdere, altså nøglen til hvem
[PERSON_1]er, forbliver kun i din browser. Uden det er de anonymiserede data uforståelige for alle andre. - Hvert resultat er mærket som skabt af kunstig intelligens i henhold til artikel 50 i AI-forordningen; citaterne er verificeret mod korpuset, men beslutningen er fortsat din.
- Betalte konti og API-nøgler administreres adskilt fra indholdet af forespørgsler; for MCP-forbindelsen gemmer vi kun forespørgselsteksten med henblik på grænser og forbedring af søgningen, aldrig de uploadede dokumenter.
Fordele for jurister og for research
Verificerede citater i stedet for hallucinationer. Grænsefladen citerer intet, den ikke finder i korpuset, og for hvert udkast vises graden af kildeunderstøttelse. De fiktive domme, som har fået domstole i Spanien, Irland og andre lande til at sanktionere advokater, opstår ikke her.
Grænseoverskridende research i én forespørgsel. En klient med en filial i Tyskland, en leverandør i Polen og en tvist i Østrig indebærer tre retssystemer; Europaius gennemsøger dem samtidig og returnerer ECLI-numre, der kan citeres direkte.
Din AI, vores korpus. Via MCP-forbindelsen arbejder du fortsat i Claude, ChatGPT eller Copilot, blot med den forskel, at modellen trækker på verificerede love og afgørelser i stedet for hukommelse.
Hastighed og pris. Analyse af en skrivelse tager få minutter, gebyrberegneren få sekunder, og grundlæggende søgning er gratis. Ingen installation, ingen flerårig kontrakt.
Trin-for-trin-vejledning
- Åbn Dokumentanalyse og upload en PDF, en scanning eller indsæt tekst.
- I vinduet „Hvad vil du gøre med dokumentet“ vælger du mål, rolle og tilføjer kontekst.
- Klik på Anonymisér dokument, kontrollér den anonymiserede tekst, og redigér den eventuelt.
- Start analysen: du får frister, trin, relevante bestemmelser og et udkast til indlæg med verificerede citater.
- Kopiér eller download resultatet; navne og oplysninger er tilføjet igen. Dokumentet er på det tidspunkt væk fra serveren.
- Til research i et andet land skifter du land i toppen, eller du kobler korpuset til din egen AI via MCP.
https://mcp.europaius.com/mcp
Ofte stillede spørgsmål
Ser sprogmodellen mit dokument?
Ikke i den oprindelige form. Modellen modtager den anonymiserede tekst, hvor navne, numre og adresser er erstattet med pladsholdere, samt uddrag af love og afgørelser fra vores korpus.
Hvad sker der med dokumentet efter behandling?
Det kasseres. Dokumentet og mellemresultaterne findes kun i serverens arbejdshukommelse under behandlingen; de forbliver hverken på disk eller i logfiler, når svaret er sendt.
Kan I læse scanninger og fotos?
Ja, OCR kører direkte på vores server på ti sprog. Cloud-baseret genkendelse anvendes kun, hvis den lokale OCR ikke kan udtrække teksten, og altid efter din bekræftelse.
Kan jeg anonymisere uden at køre en analyse?
Ja, det selvstændige værktøj Dokumentanonymisering returnerer den anonymiserede tekst til download sammen med et kort over pladsholdere, som kun brugeren har.
Hvordan ved jeg, at et citat findes?
Hver paragraf og afgørelse i udkastet er et link til korpuset; for hvert udkast angives graden af kildeunderstøttelse. Det, der ikke findes i korpuset, citeres ikke af grænsefladen.
Hvilke lande er dækket?
Tjekkiet og 25 andre EU-lande, hver med sin egen sprogversion, kildeoversigt og gebyrberegner, hvor takstlisten er kendt.